Проект OpenResearch, выпущенный командой AlphaXiv, стремительно набирает популярность в среде разработчиков и исследователей. С момента публикации исходного кода на GitHub репозиторий занял лидирующую позицию в рейтинге популярности, что свидетельствует о высокой потребности сообщества в инструментах автоматизации научной работы. Основная идея проекта заключается в создании автономного ИИ-агента, способного выполнять полноценный цикл исследований: от сбора и анализа научной литературы до проведения экспериментальных симуляций и формулирования выводов. Важнейшим преимуществом решения является его полная локальность — весь процесс обработки данных происходит на устройстве пользователя без необходимости передавать конфиденциальную информацию в облака сторонних сервисов.
Как работает автономный исследователь
В основе OpenResearch лежит архитектура, способная декомпозировать сложную научную задачу на серию более мелких подзадач. Пользователь формулирует общую цель исследования — например, «проанализируйте влияние новых материалов на эффективность солнечных панелей» — и агент начинает самостоятельную работу. Сначала он проводит поиск актуальной литературы в базах данных, фильтруя источники по релевантности. Затем система извлекает ключевые данные из тысяч страниц текста, суммирует их и выявляет противоречия или пробелы в существующих знаниях.
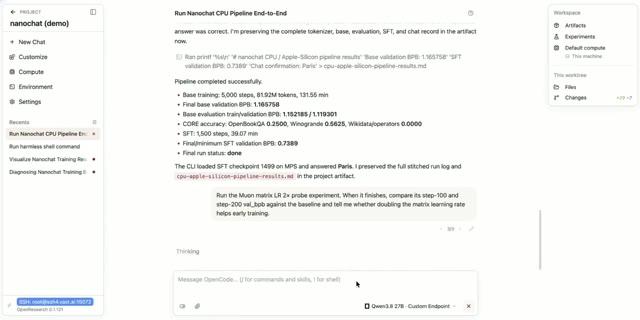
Далее агент переходит к активной фазе: он может генерировать код для проведения экспериментальных симуляций, используя инструменты вроде Claude Code, Codex или Open Code. Это позволяет модели не просто описывать гипотетические сценарии, а проверять их на практике через вычисления. Если результаты симуляции не соответствуют ожиданиям, агент корректирует параметры эксперимента и запускает новую итерацию. Такой цикл «планирование — действие — проверка» повторяется многократно до достижения поставленной цели или сбора достаточного объема доказательств для формирования итогового отчета.
- Автоматический сбор литературы из научных баз данных
- Генерация кода для симуляций и экспериментов
- Самостоятельная коррекция гипотез на основе результатов
- Формирование структурированного отчета с выводами
Полная локальность как ключевое преимущество
В отличие от многих облачных аналогов, OpenResearch работает полностью на стороне клиента. Это решает сразу несколько критических проблем: безопасность данных и независимость от интернет-соединения. В научных кругах часто возникает вопрос о конфиденциальности исследований — особенно если речь идет о коммерческой разработке или работе с чувствительными данными. Использование локальных моделей исключает риск утечки информации при передаче запросов на серверы провайдеров больших языковых моделей.
Поддержка работы с Claude Code, Codex и Open Code открывает широкое поле для экспериментов. Пользователь может выбирать под капотом ту модель, которая лучше всего подходит для конкретной задачи: более мощную версию для сложных вычислений или легкую для быстрых проверок гипотез. При этом вся инфраструктура развертывается на собственном железе, что дает полный контроль над ресурсами и позволяет масштабировать вычисления в зависимости от доступной мощности компьютера.
Сравнение с облачными конкурентами
На фоне популярных облачных сервисов автоматизации исследований OpenResearch выделяется своей приватностью и независимостью. Облачные решения, безусловно, обладают огромным преимуществом в скорости и доступности вычислительных мощностей — пользователь не тратит время на настройку окружения. Однако цена этой удобствой часто является конфиденциальность данных. Для академических институтов или компаний, работающих в чувствительных отраслях, локальное решение становится единственным приемлемым вариантом.
Стоит также отметить, что облачные сервисы часто ограничивают доступ к своим инструментам через платные подписки с жесткими лимитами. OpenResearch, будучи открытым проектом на GitHub, предоставляет бесплатный доступ к функционалу. Это делает его привлекательным как для студентов и исследователей с ограниченными бюджетами, так и для энтузиастов, желающих экспериментировать с технологиями ИИ без финансовых вложений.
Практическое применение и ограничения
Для кого же предназначен OpenResearch? Идеальный кандидат — исследователь или разработчик, работающий над проектом, требующим анализа больших массивов данных. Например, при подготовке обзорной статьи по узкой теме агент способен за считанные часы обработать сотни публикаций, выделить основные тренды и предложить направления для дальнейших экспериментов. Это освобождает человека от рутинной работы по чтению и суммированию информации, позволяя сосредоточиться на интерпретации результатов и формировании новых идей.
Однако важно быть честным относительно ограничений технологии. ИИ-агент не заменяет полностью человеческий интеллект — он работает в рамках своих обучающих данных и может совершать ошибки при интерпретации сложных или многозначных контекстов. Пользователю необходимо критически оценивать выводы модели, проверять корректность сгенерированного кода и подтверждать результаты экспериментов реальными данными. Кроме того, локальное развертывание требует наличия достаточно мощного оборудования — видеокарты с большой видеопамятью и много ядер процессора для параллельных вычислений.
Как начать использовать OpenResearch
Для запуска проекта не требуется сложных настроек или специальных знаний в области DevOps. Достаточно скачать репозиторий с GitHub, установить зависимости и запустить скрипт инициализации. В интерфейсе можно ввести тему исследования, настроить параметры поиска литературы и симуляций. Система сама предложит план действий, который можно скорректировать под конкретные нужды.
Открытость кода позволяет сообществу вносить улучшения и расширять функционал. Уже сейчас энтузиасты создают плагины для интеграции с другими инструментами управления задачами и базами данных. Это превращает OpenResearch в платформу, которая может развиваться вместе с потребностями пользователей. Бесплатный доступ к такой мощной технологии открывает новые горизонты для научного поиска и автоматизации рутинных задач в области искусственного интеллекта.