Разработчики из китайской компании Baidu представили новую модель под названием Unlimited-OCR 2. Это инструмент для распознавания текста на изображениях (OCR), который, по словам авторов, способен обрабатывать тысячи страниц документа одновременно. Модель доступна в открытом доступе на GitHub и предлагается бесплатно для использования.
Как работает новая версия
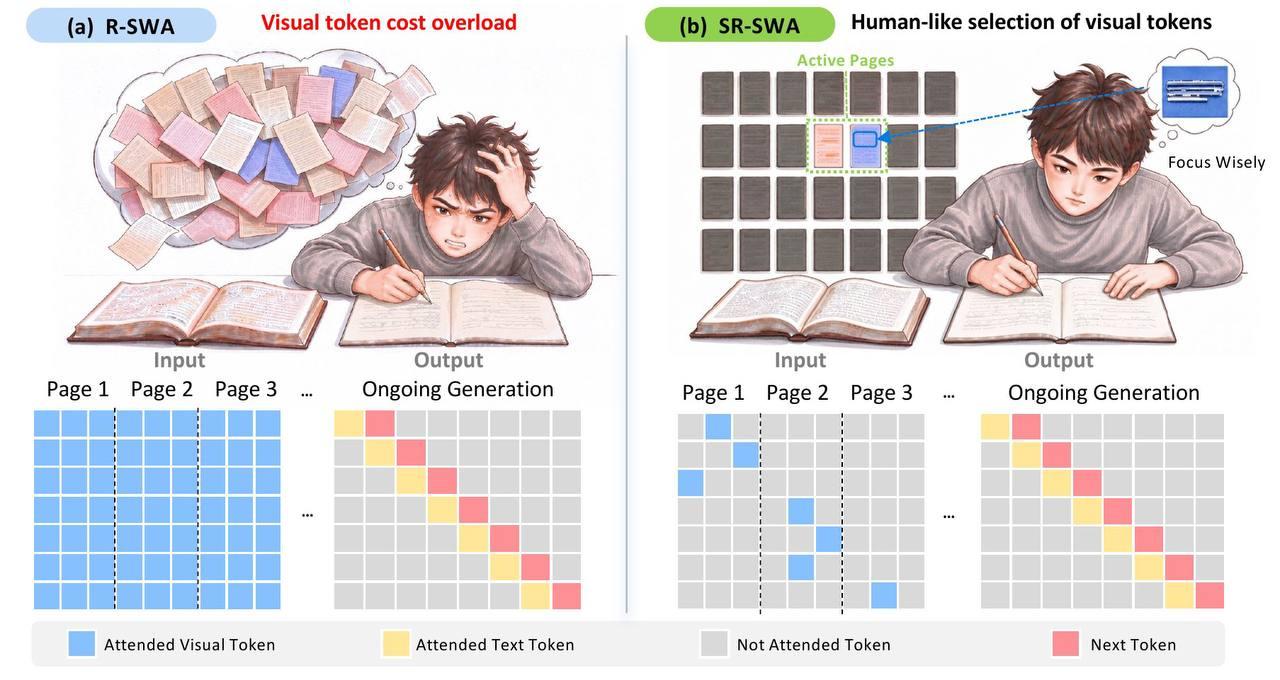
Главная техническая особенность Unlimited-OCR 2 заключается в подходе к обработке данных. Вместо того чтобы пытаться проанализировать изображение целиком, как это делали многие предыдущие системы, модель использует только те фрагменты изображения, которые действительно содержат текст или важные элементы. Этот метод позволяет значительно снизить потребление оперативной памяти — расход снижен «в разы» по сравнению с аналогами, что делает возможным обработку очень больших файлов.
В тестах производительность модели была продемонстрирована на материале из семи книг о Гарри Поттере. Система успешно распознала весь текст, включая сложные элементы вроде таблиц и математических формул, которые часто являются проблемой для стандартных OCR-движков. Такой подход позволяет вытаскивать данные с высокой точностью даже из плотных документов.
- Мгновенная обработка тысяч страниц текста
- Поддержка сложных элементов: таблицы, формулы, рукописный текст
- Оптимизированный расход памяти благодаря селективной обработке фрагментов
- Полностью бесплатное использование без ограничений по API-вызовам
Сравнение с конкурентами и аналогами
На рынке OCR-решений традиционно лидируют продукты от Google, Microsoft и Amazon, которые часто интегрированы в свои экосистемы облачных вычислений. Однако эти сервисы обычно требуют подключения к платному API или установки тяжелых клиентских агентов на сервера. Open-source решения вроде Tesseract остаются популярными, но часто уступают современным нейросетям по точности на сложных текстах.
Unlimited-OCR 2 занимает промежуточную нишу: она предлагает возможности современных облачных моделей (высокая точность на сложном контенте), но при этом является полностью бесплатным и может быть развернута локально. Это особенно важно для организаций, которые работают с большими объемами конфиденциальных данных и не хотят передавать их в сторонние облака. Снижение потребления памяти также позволяет запускать такую систему на более доступном оборудовании.
Стоит отметить, что многие конкуренты требуют значительных вычислительных ресурсов для обработки больших файлов из-за необходимости загружать модель целиком и поддерживать высокий уровень буферизации данных. Новый подход Baidu меняет эту парадигму, позволяя обрабатывать документы размером в сотни мегабайт без «зависаний» системы.
Практическое применение
Этот инструмент может быть полезен в самых разных сценариях: от автоматизации архивирования документов и перевода старых книг на электронный формат до анализа научных статей и отчетов. Для компаний, которые занимаются оцифровкой больших массивов данных, Unlimited-OCR 2 предлагает решение проблемы стоимости хранения и обработки информации.
Разработчики разместили исходный код проекта в репозитории GitHub, где пользователи могут скачать модель, изучить архитектуру и адаптировать её под свои задачи. Для тех, кто не хочет заниматься развертыванием, проект также предоставляет инструкции по установке и настройке окружения.
Если вы работаете с большим количеством сканированных документов или печатных изданий, стоит попробовать эту модель. Она демонстрирует, что современные методы обработки изображений могут быть эффективными даже при минимальных затратах на инфраструктуру. Важно помнить, что качество распознавания всегда зависит от качества исходного изображения — четкие и контрастные тексты будут обрабатываться лучше всего.
Как начать использовать
Для начала работы достаточно перейти на страницу проекта на GitHub, скопировать ссылку на репозиторий и установить необходимые зависимости. В проекте есть подробная документация, которая поможет настроить окружение и запустить первую обработку файла. Если у вас уже есть опыт работы с Python и библиотеками для машинного обучения, интеграция в существующие пайплайны обработки данных не займет много времени.
Технология распознавания текста продолжает развиваться, и появление таких решений, как Unlimited-OCR 2, показывает, что акцент смещается не только на точность, но и на эффективность использования ресурсов. Это открывает новые возможности для малого бизнеса и исследователей, которые раньше могли позволить себе использовать только облачные сервисы.